Domain mlai.de kaufen?
Wir ziehen mit dem Projekt
mlai.de um.
Sind Sie am Kauf der Domain
mlai.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain mlai.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Data
Top-Angebote
Produkte zum Begriff Data:
-
Evolutionary Computation in Data Mining, Fachbücher von Ashish GhoshData Mining (DM) besteht darin, interessante Erkenntnisse aus realen, grossen und komplexen Datensätzen zu extrahieren und ist der zentrale Schritt eines umfassenderen Prozesses, der als Wissensentdeckung aus Datenbanken (KDD) bezeichnet wird. Neben dem DM-Schritt, der Wissen aus Daten extrahiert, umfasst der KDD-Prozess mehrere Vorverarbeitungs- (oder Datenvorbereitungs-) und Nachbearbeitungsschritte (oder Wissensverfeinerung). Das Ziel der Methoden zur Datenvorverarbeitung besteht darin, die Daten so zu transformieren, dass die Anwendung eines oder mehrerer gegebener DM-Algorithmen erleichtert wird, während das Ziel der Methoden zur Wissensverfeinerung darin besteht, entdecktes Wissen zu validieren und zu verfeinern. Idealerweise sollte das entdeckte Wissen nicht nur genau, sondern auch verständlich und interessant für den Benutzer sein. Der gesamte Prozess ist sehr rechenintensiv. Die Idee, Wissen automatisch aus Datenbanken zu entdecken, ist eine sehr attraktive und herausfordernde Aufgabe, sowohl für die Wissenschaft als auch für die Industrie. Daher gibt es ein wachsendes Interesse an Data Mining in mehreren KI-bezogenen Bereichen, einschliesslich evolutionärer Algorithmen (EAs). Die Hauptmotivation für die Anwendung von EAs auf KDD-Aufgaben besteht darin, dass sie robuste und adaptive Suchmethoden sind, die eine globale Suche im Raum der Kandidatenlösungen, wie Regeln oder andere Formen der Wissensdarstellung, durchführen.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
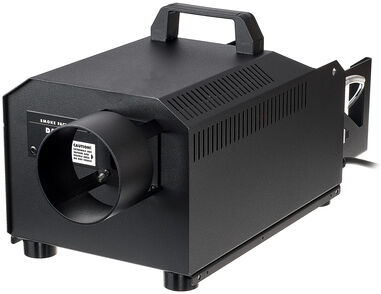
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Künstliche Intelligenz und Data Science in Theorie und Praxis, Fachbücher von Göran Kauermann, Andreas Gillhuber, Wolfgang HaunerDieser Sammelband verbindet theoretische Grundlagen und praktische Anwendungen von Künstlicher Intelligenz (KI) und Data Science. Anerkannte Experten stellen in ihren Beiträgen den aktuellen Stand in Forschung und Wirtschaft dar und bieten so einen einzigartigen Überblick über aktuelle Konzepte und deren Umsetzung in Unternehmen. Im ersten Teil des Buchs werden die Methoden und Algorithmen skizziert, die sich grösstenteils aus einer Kombination von Statistik und Informatik ergeben und auf Verfahren des maschinellen Lernens bis hin zu Deep Learning und KI basieren. Im zweiten Teil wird die konzeptionelle Umsetzung in der Praxis skizziert: Hier wird insbesondere aufgezeigt, welche Herausforderungen in der Praxis auftreten – ob nun bei der Einbettung der Daten-Use-Cases in eine Gesamtstrategie oder bei der Produktivsetzung, Weiterentwicklung und dem Betrieb von datenbasierten Lösungen. Der dritte Teil zeigt das breite Potpourri von Data Science in der Praxis: Branchengrössen wie Allianz, ADAC, BMW, Deutsche Bahn, Lufthansa, REWE, RTL, St. Galler Stadtwerke, SwissRe und viele weitere zeigen konkret, welche Erfahrungen sie bei ihren Projekten gesammelt haben. Fachartikel von über 20 namhaften Unternehmen decken die spezifischen Anforderungen ihrer jeweiligen Branchen ab. Das Buch möchte die interdisziplinäre Diskussion und Kooperation zwischen Wissenschaft und Wirtschaft fördern und richtet sich daher an verschiedene Lesergruppen: Studierende und Absolventen, die Orientierung für die eigene Laufbahn suchen; Forschende und Lehrende, die einen Einblick in praxisrelevante Einsatzgebiete erhalten möchten; Anwender, Praktiker und Entscheider, die sich über Chancen und Herausforderungen von KI in der Praxis informieren möchten.54,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Ist Machine Learning bereits künstliche Intelligenz?
Machine Learning ist ein Teilgebiet der künstlichen Intelligenz. Es befasst sich mit der Entwicklung von Algorithmen und Modellen, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Künstliche Intelligenz umfasst jedoch auch andere Bereiche wie Expertensysteme, natürliche Sprachverarbeitung und Robotik. **
-
Wie beeinflusst künstliche Intelligenz den Bereich der Informatik? Welche Rolle spielen Big Data und Data Mining in der Informatik?
Künstliche Intelligenz optimiert Prozesse in der Informatik, automatisiert Aufgaben und ermöglicht neue Anwendungen wie maschinelles Lernen. Big Data und Data Mining sind wichtige Werkzeuge in der Informatik, um große Datenmengen zu analysieren, Muster zu erkennen und fundierte Entscheidungen zu treffen. Sie spielen eine zentrale Rolle bei der Entwicklung von KI-Systemen und der Optimierung von Algorithmen. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Wie funktioniert Big Data Analytics?
Wie funktioniert Big Data Analytics? Big Data Analytics beinhaltet die Verarbeitung und Analyse großer Mengen von Daten, um Muster, Trends und Erkenntnisse zu identifizieren. Zunächst werden die Daten gesammelt und gespeichert, dann werden sie mithilfe von speziellen Tools und Algorithmen analysiert. Durch den Einsatz von Data Mining, maschinellem Lernen und künstlicher Intelligenz können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. Die Ergebnisse der Analyse können für verschiedene Anwendungen genutzt werden, wie z.B. zur Verbesserung von Produkten und Dienstleistungen, zur Optimierung von Geschäftsprozessen oder zur Vorhersage von zukünftigen Entwicklungen. **


Ist der Apriori-Algorithmus dem maschinellen Lernen oder dem Data Mining zuzuordnen?
Der Apriori-Algorithmus ist dem Data Mining zuzuordnen. Er wird verwendet, um häufige Muster in großen Datensätzen zu entdecken, insbesondere in der Assoziationsanalyse. Obwohl er in einigen maschinellen Lernverfahren verwendet werden kann, liegt sein Hauptanwendungsbereich im Data Mining. **
Was ist der Unterschied zwischen Deep Learning und Machine Learning?
Deep Learning ist eine spezielle Methode des Machine Learning, die auf künstlichen neuronalen Netzwerken basiert. Es ermöglicht das Lernen von hierarchischen und komplexen Merkmalsdarstellungen, um automatisch Muster und Strukturen in Daten zu erkennen. Im Gegensatz dazu ist Machine Learning ein breiterer Begriff, der verschiedene Algorithmen und Techniken umfasst, um Computermodelle zu erstellen, die aus Daten lernen und Vorhersagen treffen können. Deep Learning ist also eine Teilmenge des Machine Learning. **
Top-Angebote
Produkte zum Begriff Data:
-
Inference and Learning from Data: Volume 3, Fachbücher von Ali H. SayedDas Buch "Inference and Learning from Data: Volume 3" bietet eine umfassende und tiefgehende Analyse von Methoden und Techniken im Bereich des maschinellen Lernens und der Datenanalyse. Es behandelt eine Vielzahl von Themen, die von klassischen Ansätzen wie der linearen Regression und Entscheidungsbäumen bis hin zu modernen Methoden wie tiefen neuronalen Netzwerken und generativen Modellen reichen. Die Inhalte sind strukturiert und klar gegliedert, was es sowohl für Studierende als auch für Fachleute in den Sozialwissenschaften zu einer wertvollen Ressource macht. Die behandelten Konzepte werden durch praktische Beispiele und theoretische Erklärungen ergänzt, um ein besseres Verständnis der Materie zu fördern. Dieses Buch ist ein unverzichtbares Nachschlagewerk für alle, die sich mit den Herausforderungen und Möglichkeiten des maschinellen Lernens auseinandersetzen möchten. - Umfassende Analyse von maschinellen Lernmethoden - Behandlung klassischer und moderner Techniken - Strukturierte und klare Gliederung der Inhalte - Praktische Beispiele zur Vertiefung des Verständnisses.119,77 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Data Analytics, Fachbücher von Johannes KröckelEiner der Schwerpunkte von Industrie 4.0 ist die Integration von Big Data Technologien in Fertigung und Logistik. Auf Basis von bestehenden meist ungenutzten sowie zusätzlich aufgezeichneten Daten ergeben sich ungeahnte Potenziale für Effizienzsteigerungen und Kostensenkungen. Neue digitale Produkte und Dienstleistungen ermöglichen produzierenden Unternehmen darüber hinaus neue gewinnbringende Geschäftsmodelle, mit denen sie Kundenbedürfnisse noch besser abdecken bzw. neue Kunden akquirieren können. Dabei spielen effiziente Machine Learning Algorithmen für die automatisierte, objektive, zuverlässige und schnelle Verarbeitung und Auswertung grosser industrieller Datenmengen eine zentrale Rolle. Das Buch führt Businessziele und analytische Lösungswege in pragmatischer Art und Weise zusammen. Es bietet nicht nur einen guten Überblick zu den in der Fertigung und Logistik anwendbaren Data Mining Algorithmen, sondern liefert auch konkrete Use Cases, die mit diesen Algorithmen erfolgreich umgesetzt werden können. • Rollen und Teamstruktur • Vorgehen • Daten • Handwerkszeug (Algorithmen und Methoden) • Use Cases aus dem Bereich Produktion und Logistik.49,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Evolutionary Computation in Data Mining, Fachbücher von Ashish GhoshData Mining (DM) besteht darin, interessante Erkenntnisse aus realen, grossen und komplexen Datensätzen zu extrahieren und ist der zentrale Schritt eines umfassenderen Prozesses, der als Wissensentdeckung aus Datenbanken (KDD) bezeichnet wird. Neben dem DM-Schritt, der Wissen aus Daten extrahiert, umfasst der KDD-Prozess mehrere Vorverarbeitungs- (oder Datenvorbereitungs-) und Nachbearbeitungsschritte (oder Wissensverfeinerung). Das Ziel der Methoden zur Datenvorverarbeitung besteht darin, die Daten so zu transformieren, dass die Anwendung eines oder mehrerer gegebener DM-Algorithmen erleichtert wird, während das Ziel der Methoden zur Wissensverfeinerung darin besteht, entdecktes Wissen zu validieren und zu verfeinern. Idealerweise sollte das entdeckte Wissen nicht nur genau, sondern auch verständlich und interessant für den Benutzer sein. Der gesamte Prozess ist sehr rechenintensiv. Die Idee, Wissen automatisch aus Datenbanken zu entdecken, ist eine sehr attraktive und herausfordernde Aufgabe, sowohl für die Wissenschaft als auch für die Industrie. Daher gibt es ein wachsendes Interesse an Data Mining in mehreren KI-bezogenen Bereichen, einschliesslich evolutionärer Algorithmen (EAs). Die Hauptmotivation für die Anwendung von EAs auf KDD-Aufgaben besteht darin, dass sie robuste und adaptive Suchmethoden sind, die eine globale Suche im Raum der Kandidatenlösungen, wie Regeln oder andere Formen der Wissensdarstellung, durchführen.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Ist Machine Learning bereits künstliche Intelligenz?
Machine Learning ist ein Teilgebiet der künstlichen Intelligenz. Es befasst sich mit der Entwicklung von Algorithmen und Modellen, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Künstliche Intelligenz umfasst jedoch auch andere Bereiche wie Expertensysteme, natürliche Sprachverarbeitung und Robotik. **
-
Wie beeinflusst künstliche Intelligenz den Bereich der Informatik? Welche Rolle spielen Big Data und Data Mining in der Informatik?
Künstliche Intelligenz optimiert Prozesse in der Informatik, automatisiert Aufgaben und ermöglicht neue Anwendungen wie maschinelles Lernen. Big Data und Data Mining sind wichtige Werkzeuge in der Informatik, um große Datenmengen zu analysieren, Muster zu erkennen und fundierte Entscheidungen zu treffen. Sie spielen eine zentrale Rolle bei der Entwicklung von KI-Systemen und der Optimierung von Algorithmen. **
Ähnliche Suchbegriffe für Data
-
Künstliche Intelligenz und Data Science in Theorie und Praxis, Fachbücher von Göran Kauermann, Andreas Gillhuber, Wolfgang HaunerDieser Sammelband verbindet theoretische Grundlagen und praktische Anwendungen von Künstlicher Intelligenz (KI) und Data Science. Anerkannte Experten stellen in ihren Beiträgen den aktuellen Stand in Forschung und Wirtschaft dar und bieten so einen einzigartigen Überblick über aktuelle Konzepte und deren Umsetzung in Unternehmen. Im ersten Teil des Buchs werden die Methoden und Algorithmen skizziert, die sich grösstenteils aus einer Kombination von Statistik und Informatik ergeben und auf Verfahren des maschinellen Lernens bis hin zu Deep Learning und KI basieren. Im zweiten Teil wird die konzeptionelle Umsetzung in der Praxis skizziert: Hier wird insbesondere aufgezeigt, welche Herausforderungen in der Praxis auftreten – ob nun bei der Einbettung der Daten-Use-Cases in eine Gesamtstrategie oder bei der Produktivsetzung, Weiterentwicklung und dem Betrieb von datenbasierten Lösungen. Der dritte Teil zeigt das breite Potpourri von Data Science in der Praxis: Branchengrössen wie Allianz, ADAC, BMW, Deutsche Bahn, Lufthansa, REWE, RTL, St. Galler Stadtwerke, SwissRe und viele weitere zeigen konkret, welche Erfahrungen sie bei ihren Projekten gesammelt haben. Fachartikel von über 20 namhaften Unternehmen decken die spezifischen Anforderungen ihrer jeweiligen Branchen ab. Das Buch möchte die interdisziplinäre Diskussion und Kooperation zwischen Wissenschaft und Wirtschaft fördern und richtet sich daher an verschiedene Lesergruppen: Studierende und Absolventen, die Orientierung für die eigene Laufbahn suchen; Forschende und Lehrende, die einen Einblick in praxisrelevante Einsatzgebiete erhalten möchten; Anwender, Praktiker und Entscheider, die sich über Chancen und Herausforderungen von KI in der Praxis informieren möchten.54,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Big Data Analytics, Fachbücher von Andreas Meier, Sara D'OnofrioMit diesem Herausgeberwerk führen die Autoren den Begriff "Big Data Analytics" ein und geben Fallstudien aus unterschiedlichen Anwendungsgebieten. Unter Big Data Analytics wird das Aufbereiten, Analysieren und Interpretieren von grossen, oft heterogenen Datenbeständen verstanden, mit dem Ziel, Muster und Zusammenhänge in den Daten aufzudecken und Entscheidungsgrundlagen für wissenschaftliche, betriebliche oder gesellschaftliche Fragestellungen zu erhalten. Nebst den theoretischen Grundlagen widmet sich das Herausgeberwerk der Vielfalt verschiedener Anwendungsmöglichkeiten. Fallbeispiele geben Einblick in die Anwendung von Big Data Analytics und dessen Nutzenpotenziale. Das Werk richtet sich gleichermassen an Studierende, Fachleute aller Fachrichtungen als auch an interessierte Anwender. Es hilft den Leserinnen und Lesern, die Bedeutungsvielfalt des Begriffs Big Data Analytics zu verstehen und verschiedene Einsatzmöglichkeiten im eigenen Umfeld zu erkennen und zu bewerten.75,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Fraud Data Analytics Methodology, Ratgeber von Leonard W. VonaDer "Fraud Data Analytics Methodology" Ratgeber bietet eine umfassende Anleitung zur Identifizierung und Analyse von Betrugsrisiken durch effektive Datenanalytik. In einer Zeit, in der professionelle Standards verlangen, dass alle Audits Datenanalysen einbeziehen, stellt dieses Buch einen klaren und zuverlässigen Rahmen für die Entwicklung eines robusten Datenanalyseplans bereit. Es kombiniert Betrugsrisikobewertung mit bewährten Techniken, um versteckte Anzeichen von Betrug in Unternehmensdatenbanken aufzudecken. Die strategischen Anleitungen helfen dabei, Dateninterrogationsroutinen in den Prüfungsprozess zu integrieren, um rote Flaggen und betrügerische Transaktionen zu identifizieren. Die Methoden sind so konzipiert, dass sie ohne fortgeschrittene Softwarekenntnisse leicht implementiert werden können und sich nahtlos in bestehende Prüfungsprogramme einfügen lassen. Dieser Ratgeber ist ein unverzichtbares Werkzeug für alle, die die Herausforderungen der Betrugserkennung in modernen Geschäftssystemen meistern möchten.106,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Wie funktioniert Big Data Analytics?
Wie funktioniert Big Data Analytics? Big Data Analytics beinhaltet die Verarbeitung und Analyse großer Mengen von Daten, um Muster, Trends und Erkenntnisse zu identifizieren. Zunächst werden die Daten gesammelt und gespeichert, dann werden sie mithilfe von speziellen Tools und Algorithmen analysiert. Durch den Einsatz von Data Mining, maschinellem Lernen und künstlicher Intelligenz können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. Die Ergebnisse der Analyse können für verschiedene Anwendungen genutzt werden, wie z.B. zur Verbesserung von Produkten und Dienstleistungen, zur Optimierung von Geschäftsprozessen oder zur Vorhersage von zukünftigen Entwicklungen. **
-
Ist der Apriori-Algorithmus dem maschinellen Lernen oder dem Data Mining zuzuordnen?
Der Apriori-Algorithmus ist dem Data Mining zuzuordnen. Er wird verwendet, um häufige Muster in großen Datensätzen zu entdecken, insbesondere in der Assoziationsanalyse. Obwohl er in einigen maschinellen Lernverfahren verwendet werden kann, liegt sein Hauptanwendungsbereich im Data Mining. **
-
Was ist der Unterschied zwischen Deep Learning und Machine Learning?
Deep Learning ist eine spezielle Methode des Machine Learning, die auf künstlichen neuronalen Netzwerken basiert. Es ermöglicht das Lernen von hierarchischen und komplexen Merkmalsdarstellungen, um automatisch Muster und Strukturen in Daten zu erkennen. Im Gegensatz dazu ist Machine Learning ein breiterer Begriff, der verschiedene Algorithmen und Techniken umfasst, um Computermodelle zu erstellen, die aus Daten lernen und Vorhersagen treffen können. Deep Learning ist also eine Teilmenge des Machine Learning. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.